人材サービス業
<社内問い合わせ対応の工数を最大6割削減へ>散在する社内文書をAIで横断検索する仕組みの構築━━RAGとMCP接続により、普段使いのAIアプリからそのまま社内文書を検索・参照できる仕組みを構築
SHARE


就業規則や経費精算ルールといったバックオフィス文書と、作業手順書・仕様書・過去のトラブル対応記録といった技術文書が、部門ごとの共有フォルダやファイルサーバに長年にわたり蓄積されている企業。文書はあるのに「必要なときに探せない」状態が続き、答えを知っている一部の担当者に問い合わせが集中。聞く側は回答を待ち、聞かれる側は自分の業務を中断されるという、双方向の時間損失が発生していました。
KADODEは、新しい文書管理システムを導入するのではなく、既存の保管場所に置かれた文書をそのまま検索対象とするRAG(検索拡張生成)を構築。これをMCPで接続することで、社員が普段使っているClaudeアプリのチャット画面から自然文で社内文書を検索できる仕組みを設計しました。回答に必ず出典(ファイル名・該当箇所)を併記する方式と、権限に応じた参照範囲の制御を組み込み、社内問い合わせ対応工数の最大6割削減(想定)を見込む提案・検証事例をご紹介します。
目次
背景と課題
文書はあるのに「探せない」。問い合わせが人に集中し、聞く側・聞かれる側の双方で時間が失われる
対象となるのは、総務・人事・経理・情報システムが所管する規程類と、現場で使われる作業手順書・仕様書・過去のトラブル対応記録です。いずれも長年にわたり作成・改訂が重ねられ、部門ごとの共有フォルダやファイルサーバに蓄積されています。文書そのものは整備されている一方で、「必要なときに必要な記述へ到達する」手段が、実質的に人への問い合わせしか存在していない状態でした。
主な課題
- 検索が機能しない文書構造:フォルダ階層が部門・年度・案件で入り組み、ファイル名の付け方も統一されていない。加えてスキャンPDFなど全文検索が効かない文書も混在しており、キーワード検索では目的の記述に到達できなかった。
- 問い合わせの多くが「すでに書いてあること」の反復:寄せられる質問の相当数は、規程や手順書のどこかに答えが記載されているもの。同じ内容の質問が担当者を変えて繰り返し発生し、その都度、回答者が原本を探して要点を書き起こしていた。
- 回答する側の「中断」コスト:質問はチャットやメールで随時発生するため、管理部門の担当者やベテラン技術者は自分の作業を中断して対応する必要があった。1件あたりの回答時間は短くとも、集中を要する業務への割り込みとなるため、実質的な時間損失は問い合わせ件数から想像される以上に大きい。
- 回答の属人化と版ずれのリスク:「この件はあの人しか答えられない」という状態が固定化し、担当者の不在が業務の停滞に直結していた。また、回答者の手元にある古い版の文書を参照してしまい、改訂前のルールが回答されるリスクも残っていた。
支援内容・開発アプローチ
「新しい検索システム」ではなく「普段使うAIアプリからそのまま引ける状態」を、出典付きで実現
KADODEは、新たな文書管理システムの導入や全社的なファイル整理を前提とせず、現状の保管場所と運用をできる限り変えないまま検索性だけを引き上げる方針を採用しました。「便利だが使われない社内ツール」が一つ増える事態を避けるため、社員がすでに日常的に使っているClaudeアプリを唯一の入口とする構成としています。(※copilot等、その他のツールでも代替可能)
実施した具体的なアプローチ
- 対象文書の棚卸しと「生きている文書」の選別:全文書をやみくもに取り込むのではなく、問い合わせ実績の多い領域から対象範囲を限定。改訂済み・廃止済みの版を除外し、最新版を特定する作業を初期工程に明確に位置づけました。検索の精度は、取り込む文書の鮮度と正しさでほぼ決まります。
- 既存の保管場所を変えないRAGの構築:共有フォルダ・ファイルサーバに置かれた文書をそのまま取り込み対象とし、文書種別・所管部門・改訂日といったメタデータを付与。スキャンPDFはOCRで本文を抽出し、規程は条・項の単位、手順書は工程の単位で分割(チャンク)することで、条文や手順という業務上の意味単位で正確に引ける設計としました。
- MCPによるClaudeアプリからの接続:構築したRAGをMCPで接続し、社員は普段使っているClaudeアプリのチャット画面から自然文で質問するだけで社内文書を検索できる構成としました。新しい画面や検索構文を覚える必要がないため、「導入したが使われずに終わる」リスクを仕組みとして下げています。
- 出典の併記を必須とする回答設計:回答には必ず参照元のファイル名と該当箇所を併記する仕様とし、利用者がいつでも原本に当たって確認できる状態を確保しました。「生成AIの回答は正しいか分からない」という懸念に対し、AIは所在と要点を示し、最終的な正否は原本で確認するという運用に落とし込んでいます。根拠となる記述が見つからない場合は「該当記述なし」と返し、推測で回答させない設計としました。
- 権限に応じた参照範囲の制御:人事・経理が所管する文書には閲覧制限のあるものが含まれるため、利用者の所属・権限に応じて検索対象を分離。全社公開文書と限定公開文書を同一の検索窓で混在させない構成とし、情報統制を維持したまま検索性を高めました。
- 段階導入ロードマップの策定:問い合わせ件数の多いバックオフィス規程に絞ったPoC(1〜2ヵ月)→技術文書への対象拡張と回答精度・出典精度の検証(3〜4ヵ月)→全社展開および文書改訂プロセスへの組み込み(5ヵ月〜)という3段階の導入計画を提示し、リスクを抑えて定着させるシナリオを設計しました。
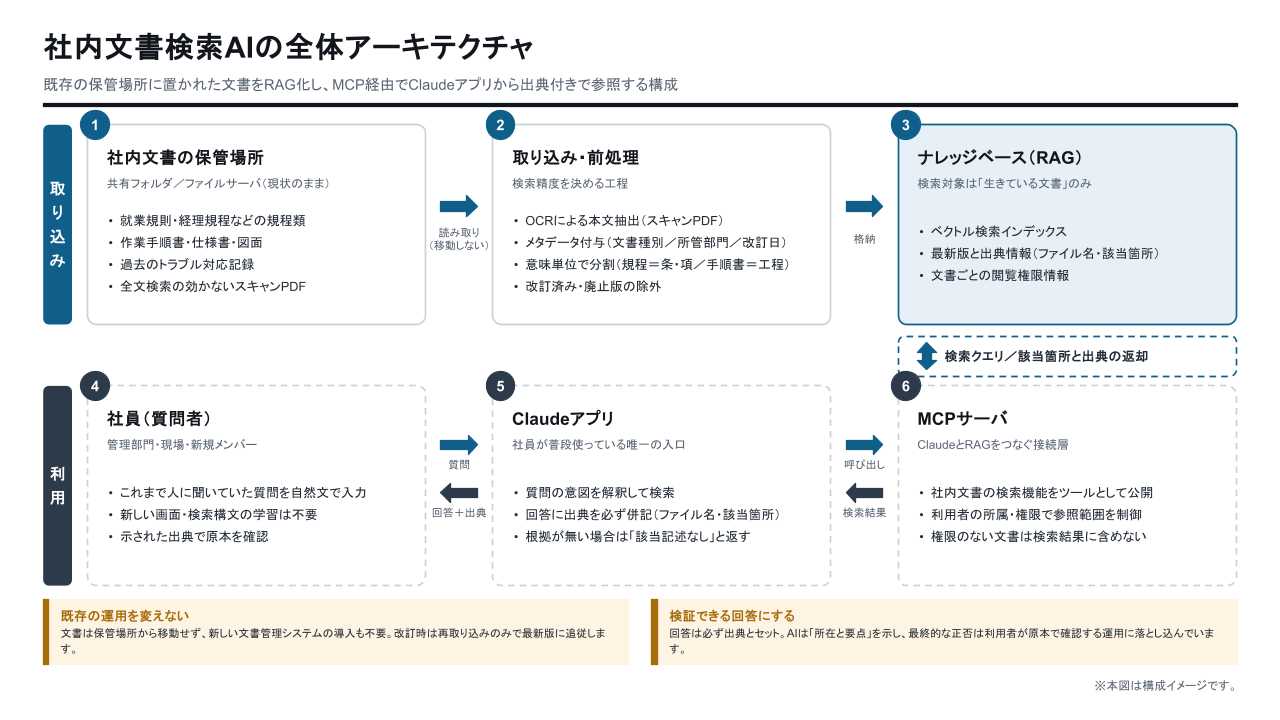
既存の保管場所に置かれた文書をRAG化し、MCP経由でClaudeアプリから出典付きで参照する構成
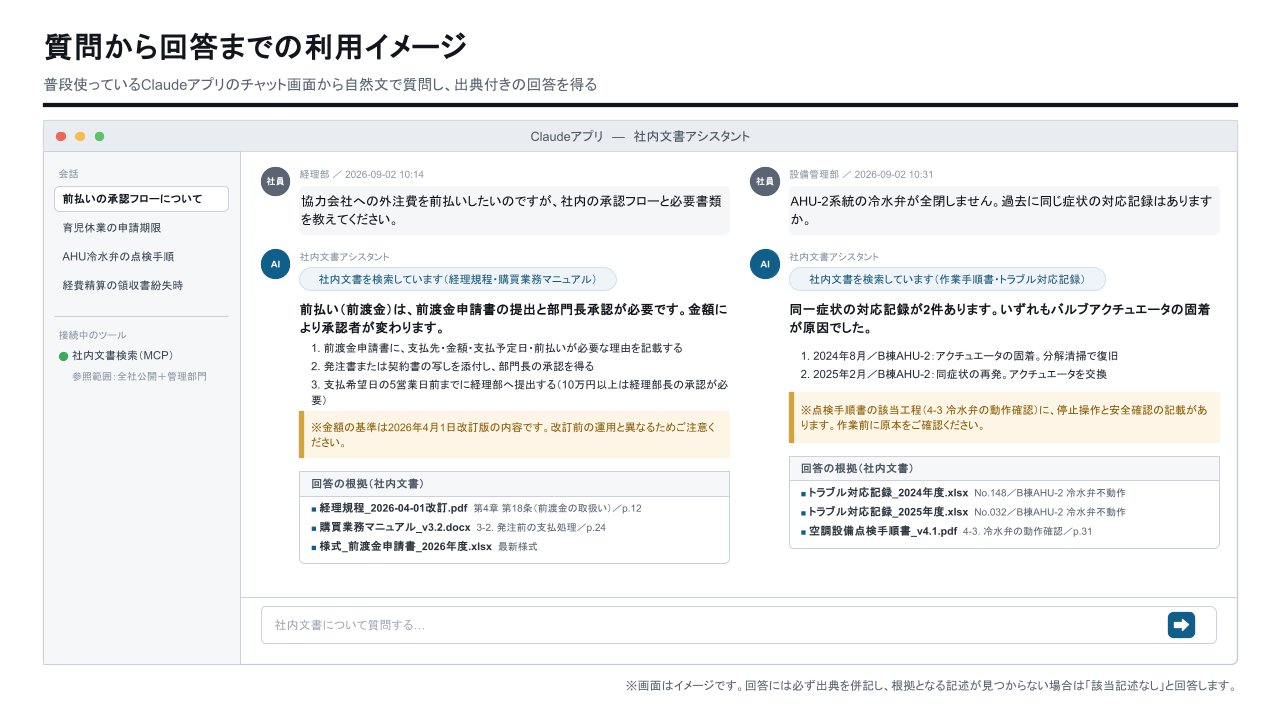
普段使っているClaudeアプリのチャット画面から自然文で質問し、出典付きの回答を得る
期待される導入効果(想定)
社内問い合わせ対応工数を最大6割削減見込み。「探す・答える」時間が「考える」時間に変わる
本事例は提案・検証段階のものであり、以下はロードマップに基づく想定効果です。PoC(実証実験)にて問い合わせ件数と回答所要時間の実測を行った上で、本格導入へ進む計画です。
期待される効果(定量・想定)
- 問い合わせの自己解決化:「文書のどこかに書いてある」類型の質問を、質問者自身がその場で解決できる状態へ移行。人へ向かっていた問い合わせの件数そのものの減少を見込みます。
- 社内問い合わせ対応工数の最大6割削減(想定):管理部門の担当者やベテラン技術者が費やしていた「質問を受ける→原本を探す→回答を作成する」という一連の対応工数について、繰り返し質問の削減により圧縮する前提での試算です。※PoCにて実測予定
- 探索時間の短縮:フォルダ階層を辿って目的の記述に到達するまでの時間を、自然文での質問1回に置き換えます。「どこにあるか分からない」ことを理由に人へ聞く行動そのものを減らします。
- 拡張時のスケーラビリティ:対象文書を追加しても仕組み自体は変わらないため、部門や文書種別を広げても運用工数が比例して増えない体制を見込みます。
期待される価値(定性)
- 回答の属人性の解消:「あの人しか答えられない」状態が緩和され、担当者の不在・異動・退職が業務の停滞に直結しにくくなります。ベテランの時間を、判断や育成といった代替の効かない業務へ振り向けられるようになります。
- 最新版の参照徹底とミス削減:出典付きで最新版の記述が示されるため、古い版のルールに基づいた回答や、それに起因する手続きのやり直しを抑制できます。
- 文書資産の棚卸しが進む:導入準備として「どの文書が生きているか」を整理する過程そのものが、長らく手つかずだった文書管理を是正する機会になります。仕組みの導入と運用の改善が同時に進みます。
- 新規メンバーの立ち上がり短縮:誰に何を聞けばよいか分からない段階でも、まず自分で調べられる状態になるため、配属直後の本人の負荷と、教える側の負荷の双方が下がります。